Core
Het productdatamodel: masterdata, hiërarchieën, varianten en SKU's uitgelegd
Stephan Spijkers · 2026-10-20 · 15 min leestijd
Elke PIM is gebouwd op een datamodel: de beslissingen over welke records er bestaan, welke attributen ze dragen, hoe ze samenhangen en waar elke waarde staat. Met een goed model kost een nieuw product minuten en bereikt één correctie elk kanaal. Met een zwak model plakken teams dezelfde beschrijving in veertig varianten, discussiëren ze over wie eigenaar is van het gewicht, en ontdekken ze bij de lancering dat de marktplaats een attribuut nodig heeft dat niemand heeft aangemaakt.
Deze gids legt de bouwstenen uit aan de hand van één doorlopend voorbeeld: de Trail Runner 2, een trailschoen van het fictieve merk Fjellstep. Deel 1 van deze serie bracht de systemen rond een PIM in kaart en Deel 2 volgde de data door onboarding, verrijking en publicatie. Dit deel opent de PIM zelf en kijkt naar de structuur die al dat werk invult.
Masterdata, rijke data en metadata
Open een willekeurig productrecord in een PIM en je ziet één scherm met velden. Daaronder horen die velden bij drie verschillende lagen, en wie die lagen door elkaar haalt, krijgt veel discussies over eigenaarschap.
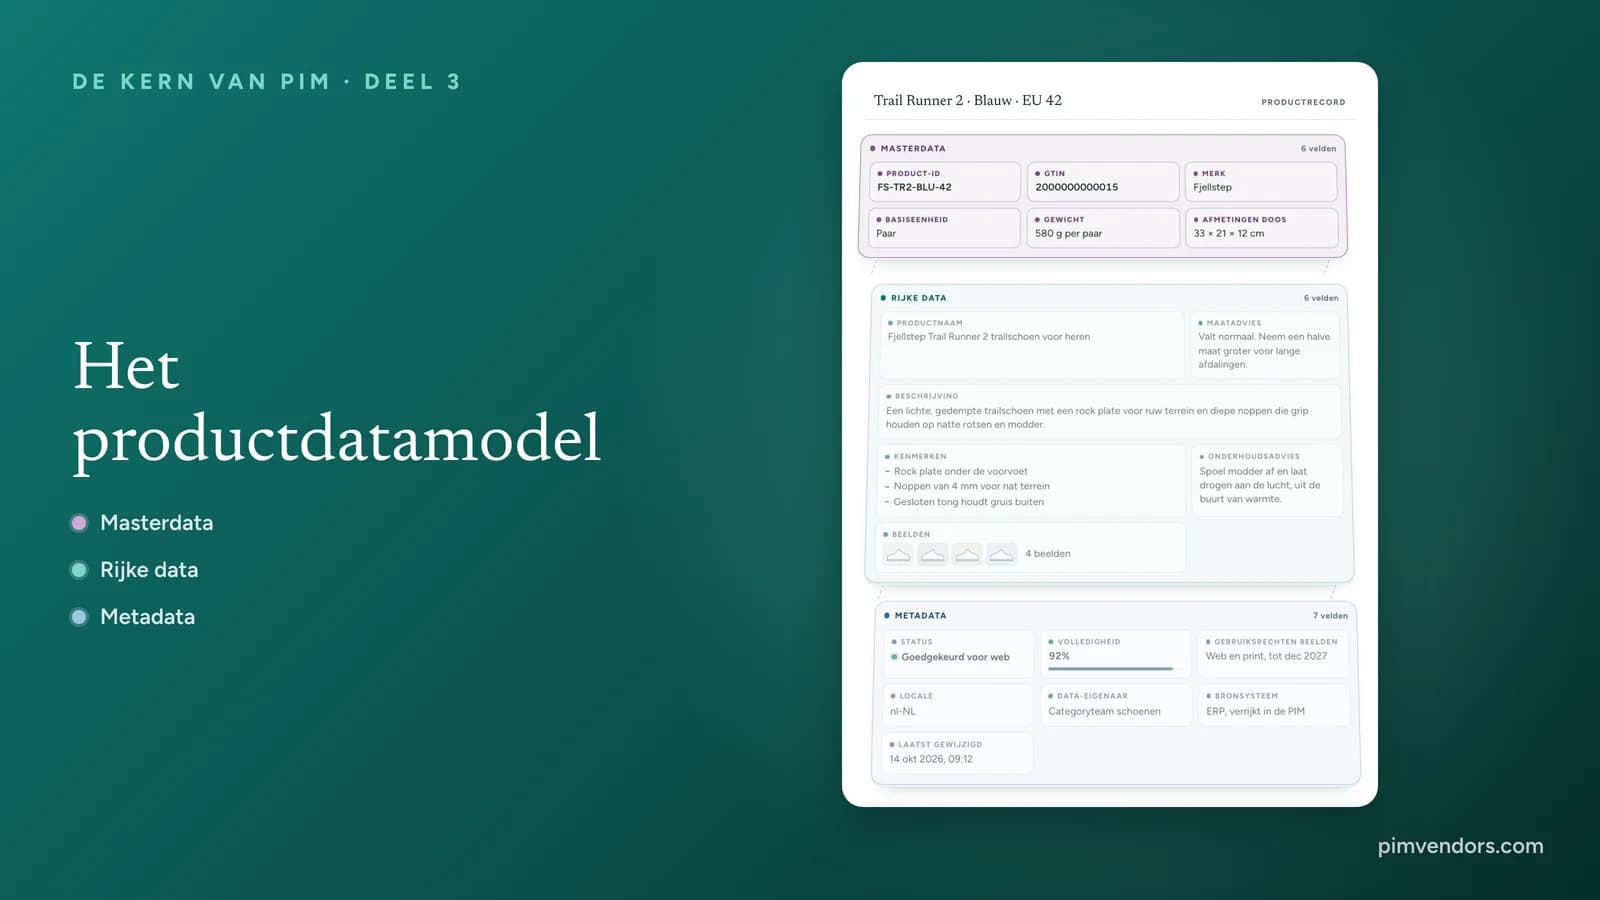
Masterdata identificeert het product: het artikelnummer, de GTIN, het merk, de basiseenheid, het gewicht en de afmetingen. Dit zijn feiten, geen meningen, en elk systeem dat met het product werkt, heeft precies dezelfde waarden nodig. Het magazijn heeft het gewicht nodig, het ERP de eenheid, de marktplaats de GTIN. Rijke data legt het product uit en verkoopt het: de naam die klanten zien, de beschrijving, kenmerken in bullets, beelden, maattabellen en onderhoudsadvies. Die data wordt geschreven voor mensen, per markt vertaald en per kanaal vormgegeven. Metadata is data over de data: waar een waarde vandaan komt, wie er eigenaar van is, wanneer die voor het laatst veranderde, hoe compleet het record is en of de beelden nog gebruikt mogen worden.
Interactief record
Eén record, drie lagen
Kies een laag om te zien welke velden erbij horen. Splits het record daarna in zijn drie lagen.
Productrecord
Trail Runner 2 · Blauw · EU 42
- Rock plate onder de voorvoet
- Noppen van 4 mm voor nat terrein
- Gesloten tong houdt gruis buiten
Merk, product en codes zijn verzonnen voorbeelden.
Wie het product is
Masterdata
De feiten die het product identificeren: de codes, het merk, de eenheid, het gewicht en de afmetingen. Elk systeem dat met het product werkt, heeft precies dezelfde waarden nodig, dus ze worden één keer aangemaakt, meestal in het ERP of een MDM, en naar alle andere systemen gekopieerd.
- Meestal beheerd door
- Een masterdatateam of productmanagement, in het ERP of de MDM
- Hoe vaak het verandert
- Zelden. Vastgelegd als het product wordt aangemaakt en alleen gewijzigd via een gecontroleerd verzoek
- Meer voorbeelden
Wie eigenaar is van elke laag
Masterdata begint meestal buiten de PIM. In de taal van Deel 1 is het ERP of een MDM daarvoor het systeem van registratie, en leest de PIM een kopie. Een gewicht dat in de PIM wordt verbeterd en niet in het ERP, geeft je twee gewichten en een magazijn dat de verkeerde verzendkosten rekent. Is er een MDM, dan houdt die één schone identiteit van het product bij voor het hele bedrijf; de principes van master data management leggen uit hoe. Rijke data is de laag waarvoor een PIM bestaat. Marketing, e-commerce en categoryteams zijn er eigenaar van, vaak met eerste versies van leveranciers en bureaus. Metadata wordt grotendeels door de PIM zelf gemaakt, en data stewards zijn eigenaar van de workflow, de kwaliteitsregels en de rechten op assets.
De drie lagen veranderen ook in een ander tempo. Masterdata wordt één keer vastgelegd en alleen via een gecontroleerd verzoek gewijzigd. Rijke data verandert elk seizoen en elke keer dat een kanaal iets nieuws vraagt. Metadata verandert bij elke bewerking, import en goedkeuring. Daarom werkt één toegangsregel voor het hele record nooit: de mensen die elke week een beschrijving mogen herschrijven, moeten geen GTIN kunnen wijzigen.
Metadata maakt een record betrouwbaar
Metadata komt zelden op een productpagina terecht, maar zonder metadata werkt de PIM niet. Volledigheidsscores bepalen of een product naar een kanaal mag worden gepubliceerd. De workflowstatus bepaalt wie er als volgende aan werkt. Herkomst (lineage) vertelt je dat een waarde vorige dinsdag uit een leveranciersbestand kwam, niet van je eigen team. Gebruiksrechten en vervaldatums voorkomen dat een beeld wordt gepubliceerd nadat de licentie is verlopen. Als mensen het over "governance" van productdata in een PIM hebben, bedoelen ze meestal deze laag. Productdatakwaliteit en governance behandelt de regels die erop draaien.
Hiërarchische en relationele modellen
Records in een PIM zijn op twee basismanieren met elkaar verbonden. In een hiërarchie heeft elk record precies één ouder: de categorie bevat het product, het product bevat zijn kleuren, elke kleur bevat zijn maten. In een relationeel model zijn records met elkaar verbonden via benoemde, gerichte relaties, en kan één record veel koppelingen van veel soorten hebben. De schoen is gemaakt door een merk, vervangt een ouder model en heeft accessoires, en dezelfde inlegzool kan een accessoire zijn voor twee verschillende schoenen.
Interactief diagram
Dezelfde records, twee vormen
Wissel tussen een strikte hiërarchie en een netwerk van getypeerde relaties. De records blijven hetzelfde. Alleen de manier waarop ze verbonden zijn, verandert.
Hiërarchie
Hiërarchie: één ouder per record
Elk record heeft precies één ouder. De categorie bevat het product, het product bevat zijn kleuren, elke kleur bevat zijn maten. Een waarde die hoog in de boom staat, wordt geërfd door alles eronder, dus één wijziging bereikt elke maat.
- Geschikt voor
- Waar het stopt
- Een boom kan niet zeggen dat de slobkous op deze schoen past, dat één inlegzool in twee modellen past, of dat de Trail Runner 2 de Trail Runner 1 vervangt. Elk daarvan vraagt om een tweede ouder, en een boom staat er maar één toe.
De meeste PIM's combineren de twee: een hiërarchie voor categorieën, productmodellen en varianten, en getypeerde relaties voor alles wat daar dwars doorheen koppelt.
Waar elke vorm goed voor is
Een hiërarchie is de juiste vorm als een record één natuurlijke ouder heeft en de waarden van die ouder moet delen. Dat geldt voor de categorieboom waarmee je producten classificeert, het productmodel met zijn varianten, en organisatorische bomen zoals productlijnen. De kracht ervan is overerving: een waarde die hoog in de boom staat, bereikt alles eronder.
Een relationeel model is de juiste vorm voor alles wat dwars door de boom heen koppelt. Accessoires en cross-sells, compatibiliteit ("deze accu past op deze zes boormachines"), reserveonderdelen, opvolgers en vervangers, bundels en sets, en koppelingen naar documenten zoals handleidingen en veiligheidsbladen zijn allemaal relaties. Een relatie heeft een type en een richting, en kan eigen attributen dragen: het aantal van elk onderdeel in een set, of een opmerking dat er een adapter nodig is. Voor producten die uit onderdelen worden samengesteld, legt stuklijsten in PIM en ERP uit waar de relatie eindigt en de productiestructuur begint.
De meeste PIM's combineren beide
In de praktijk heb je beide vormen tegelijk nodig, en meestal meer dan één hiërarchie. Een typische PIM houdt een hoofdclassificatie bij die de attributen van elk product bepaalt, aparte navigatiebomen voor elke webshop of markt, en de productmodellen met hun varianten, allemaal naast een set relatietypen. Een product staat op precies één plek in de hoofdclassificatie, maar kan in veel navigatiebomen voorkomen. Die twee uit elkaar houden is een van de nuttigste modelleerkeuzes die je kunt maken: het merchandisingteam kan het webshopmenu omgooien zonder één attribuut aan te raken.
Overerving en relaties
Overerving maakt een grote catalogus beheersbaar. Het productmodel bevat alles wat de versies delen: merk, bovenmateriaal, drop, beschrijving, onderhoudsadvies en de meeste beelden. Varianten erven die waarden en voegen alleen toe wat ze anders maakt, zoals de kleur. Maten erven van hun kleur en voegen hun eigen maat en GTIN toe. Een schoen in twee kleuren met elk drie maten is negen records met één beschrijving om te onderhouden.
Probeer het
Eén keer wijzigen, overal zien
Wijzig het bovenmateriaal op het productmodel en zie het doorlopen naar elke kleur en maat. Overschrijf het daarna op Zwart.
Productmodel
Trail Runner 2
- Merk
- Fjellstep
- Bovenmateriaal
- Engineered mesh
- Drop
- 6 mm
- Beschrijving
- Lichte trailschoen met rock plate
Variant
Blauw
- Kleur
- Blauw
- Bovenmateriaal
- Engineered mesh
EU 41
Engineered mesh
EU 42
Engineered mesh
EU 43
Engineered mesh
Variant
Zwart
- Kleur
- Zwart
- Bovenmateriaal
- Engineered mesh
EU 41
Engineered mesh
EU 42
Engineered mesh
EU 43
Engineered mesh
Eén keer ingesteld, eronder geërfd
Het productmodel bevat wat elke versie deelt. Varianten erven die waarden en voegen alleen toe wat ze anders maakt, zoals de kleur. Maten erven van hun kleur. Verbeter een waarde bovenaan en niemand hoeft acht records te bewerken.
Engineered mesh staat nu op beide kleuren en alle zes maten.
Relaties werken anders. Een relatie verbindt twee records, maar kopieert geen waarden. De slobkous die als accessoire aan deze schoen is gekoppeld, houdt zijn eigen materiaal, en een wijziging hier bereikt hem nooit.
Overrides: de uitzondering, niet de gewoonte
Soms wijkt één variant echt af. De zwarte versie krijgt een waterdicht bovenwerk, of één kleur wordt geleverd met een andere inlegzool. Een override zet een lokale waarde op dat record, en de geërfde waarde bereikt dat record en de records eronder niet meer. Overrides zijn even nuttig als gevaarlijk. Elke override is een waarde die iemand moet onthouden, en een team dat er vrij mee strooit, heeft al snel een model waarin niets meer erft. Een goede PIM laat duidelijk zien welke waarden geërfd zijn en welke lokaal zijn ingesteld, en laat je overrides in bulk opvragen en terugzetten.
De vuistregel is simpel: zet elke waarde op het hoogste niveau waar die klopt voor elk record eronder. Geldt een waarde voor het hele model, zet haar dan op het model. Geldt ze voor één kleur, zet haar dan op die kleur.
Relaties erven niet
Een relatie verbindt twee records, maar kopieert niets van het ene naar het andere. Als de slobkous als accessoire aan de Trail Runner 2 wordt gekoppeld, houdt de slobkous zijn eigen materiaal, prijs en beschrijving. Een wijziging aan de schoen bereikt de slobkous nooit. Dat is precies wat je wilt: het accessoire is een volwaardig product, met een eigen eigenaar.
Daaruit volgen twee praktische punten. Bepaal ten eerste waar een relatie staat. Een relatie op het productmodel geldt, afhankelijk van de PIM, wel of niet voor elke variant, dus controleer hoe jouw PIM daarmee omgaat voordat je duizenden koppelingen laadt. Bepaal ten tweede of relaties in beide richtingen werken. "Accessoire voor" en "heeft accessoire" zijn dezelfde koppeling, van twee kanten bekeken. Beide richtingen met de hand bijhouden verdubbelt het werk en vraagt om fouten, dus zoek een PIM die de andere kant automatisch bijwerkt.
Hoe classificatie de attribuutset bepaalt
Classificatie plaatst elk product in een boom van klassen, en die plek bepaalt welke attributen het product krijgt. De wortel van de boom voegt de attributen toe die elk product nodig heeft, zoals een ID, een naam, een merk en een hoofdbeeld. Een productfamilie voegt toe wat de familie deelt: elke schoen heeft een maatsysteem en een bovenmateriaal nodig. De klasse voegt toe wat alleen zij nodig heeft: een trailschoen heeft een drop en een profieldiepte, een accuboormachine een draaimoment en een spanbereik van de boorkop, een bank een zithoogte. De attribuutset van het product is alles wat langs het pad is verzameld.
Interactieve bouwer
De klasse bepaalt de attributen
Kies een product. Zijn plek in de classificatie bepaalt welke attributen het krijgt: een paar voor elk product, meer uit de familie en de meest specifieke uit de klasse.
Classificatiepad
- Alle producten
- Schoenen
- Hardloopschoenen
- Trailschoenen
Te mappen op een standaardklasse in GS1 GPC
Attribuutset
15 attributen, waarvan 11 verplicht
GlobaalVoor elk product
- Product-IDTekstVerplicht
- ProductnaamTekst, per taalVerplicht
- MerkLijstVerplicht
- BeschrijvingOpgemaakte tekst, per taalVerplicht
- HoofdbeeldAssetlinkVerplicht
- Land van herkomstLijstOptioneel
FamilieUit de familie: Schoenen
- MaatsysteemLijstVerplicht
- BovenmateriaalLijstVerplicht
- GeslachtLijstVerplicht
- SluitingLijstOptioneel
KlasseUit de klasse: Trailschoenen
- DropGetal, mmVerplicht
- ProfieldiepteGetal, mmVerplicht
- Gewicht per schoenGetal, gVerplicht
- Rock plateJa of neeOptioneel
- Waterdicht membraanJa of neeOptioneel
Je eigen klassen kun je mappen op een standaard zoals GS1 GPC voor consumentengoederen of ETIM voor technische producten, zodat leveranciers, datapools en klanten dezelfde attributen lezen.
Verplicht, optioneel en per kanaal
De attribuutset legt ook vast welke attributen verplicht zijn. Daarmee wordt classificatie de basis voor volledigheid: een product kan pas een score krijgen als de PIM weet bij welke klasse het hoort. Eisen verschillen vaak per kanaal, omdat een marktplaats attributen kan eisen die je eigen webshop niet toont. Deel 2 laat zien hoe classificatie en volledigheid tijdens het verrijken samenwerken.
Attribuuttypen zijn net zo belangrijk. Een drop die als getal in millimeters is opgeslagen, kun je filteren, sorteren, omrekenen en controleren. Dezelfde drop als vrije tekst ("6mm", "6 mm", "ca. 6") niet. Lijsten met vaste waarden, getallen met eenheden en ja-of-nee-velden zorgen ervoor dat filters, vergelijkingen en kanaalfeeds werken.
Je eigen klassen en de standaarden
De meeste bedrijven classificeren met een eigen boom, omdat die volgt hoe ze inkopen, verkopen en hun teams organiseren. Hun handelspartners verwachten vaak een standaard. GS1 GPC (Global Product Classification) wordt gebruikt voor consumentengoederen en in GS1-datapools. ETIM beschrijft technische producten voor de groothandel, en ECLASS is gangbaar in industriële inkoop. Als je elk van je klassen mapt op de bijbehorende standaardklasse, kunnen leveranciers data aanleveren in een vorm die je kunt importeren en kunnen klanten je attributen lezen zonder vertaaltabel. Productclassificatie en datastandaarden legt elke standaard uit en wanneer je die gebruikt.
Classificatie is geen navigatie
De hoofdclassificatie bepaalt de attributen. De categorieën in een webshop bepalen waar een product verschijnt en hoe shoppers bladeren. Ze beantwoorden verschillende vragen en veranderen in een ander tempo, dus houd ze als aparte hiërarchieën. Een product dat één keer als trailschoen is geclassificeerd, kan onder "Hardlopen", "Nieuw binnen" en "Cadeaus voor wandelaars" verschijnen zonder dat er iets aan zijn attributen verandert.
Entiteit, product, variant, SKU en artikel
Dezelfde woorden betekenen voor verschillende teams iets anders, en veel misverstanden in projecten beginnen hier. Als iemand zegt "we hebben tienduizenden producten", is de eerste vraag: geteld op welk niveau?
Zoom in
Van entiteit tot artikel
Loop door de niveaus. Elk niveau zit in het niveau ervoor, en elk heeft een eigen taak in het model.
Entiteitstypen
- Categorie
- Merk
- Leverancier
- Asset
- Document
ProductTrail Runner 2
Merk · bovenwerk · drop · beschrijving
VariantBlauw, maat 42
Kleur: Blauw · Maat: EU 42
SKUFS-TR2-BLU-42
Voorraad · prijs · levertijd
Artikel
- Paar in een doos1 paarGTIN 2000000000015
- Omdoos6 paarGTIN 2000000000022
- Blauw 41
- Blauw 43
- Zwart 42
Alle codes zijn verzonnen voorbeelden.
Niveau 1 van 5
Entiteitstypen
Een entiteitstype is een soort ding waarvan de PIM records bijhoudt. Producten zijn één type. Categorieën, merken, leveranciers, assets en documenten zijn andere. Elk type heeft eigen attributen en eigen koppelingen met de rest.
- In dit voorbeeld
- Product, categorie, merk, leverancier, asset en document
- Hoe systemen het woord gebruiken
- PIMEntiteit, objecttype of recordtype
- MDMDatadomein, zoals product, klant of leverancier
- DatabaseEen tabel, één rij per record
Een entiteitstype is een soort ding waarvan de PIM records bijhoudt. Producten zijn één type. Categorieën, merken, leveranciers, assets en documenten zijn andere, elk met eigen attributen en koppelingen. Een product is het model dat een klant herkent en waarop hij zoekt: de Trail Runner 2. Een variant is één versie die een koper kan kiezen, bepaald door de variantattributen, hier de kleur Blauw en maat 42. De SKU (stock keeping unit) is de eigen code van het bedrijf voor die exacte variant, waarmee het die variant telt, opslaat en verkoopt. Het handelsartikel is een eenheid die op een specifiek verpakkingsniveau wordt geprijsd, besteld of gefactureerd: één paar in een doos, of een omdoos met zes paar.
Waarom de woorden voor problemen zorgen
Een ERP noemt elke verkoopbare eenheid meestal een artikel en heeft daarboven geen niveau. Een webshop noemt de pagina een product en de opties erop varianten. Een magazijn telt SKU's per opslaglocatie. Modeteams praten over stijlen en kleur-maatcombinaties. Geen van deze woorden is fout, maar een model dat zijn niveaus niet duidelijk benoemt, eindigt met productpagina's die uit ERP-artikelen zijn opgebouwd, of met een apart product voor elke maat. Het telt ook commercieel: sommige PIM-licenties worden geprijsd op het aantal producten, SKU's of records, dus weet welke telling je noemt. PIM voor mode en kleding laat zien hoe niveaus voor stijl, kleur en maat uitpakken in een catalogus waarin varianten de boventoon voeren.
GTIN, SKU en verpakkingsniveaus
Een SKU is intern, dus een leverancier en een retailer hebben elk een eigen SKU voor dezelfde schoen. Een GTIN (Global Trade Item Number) wordt binnen het GS1-systeem uitgegeven en is voor elke handelspartner hetzelfde; het is het nummer in de barcode. Elk verpakkingsniveau dat wordt verhandeld, krijgt een eigen GTIN, zodat het losse paar en de omdoos met zes paar bij de scanner uit elkaar te houden zijn. In het model hoort de GTIN op het niveau van het handelsartikel, niet op het productmodel.
Zo ontwerp je je productdatamodel
Een datamodel is veel makkelijker goed te krijgen vóór de eerste import dan na de eerste grote import. Deze stappen werken voor een eerste PIM en ook voor een herontwerp.
Begin bij de kanalen en de vragen die kopers stellen
Zet op een rij wat elk kanaal nodig heeft: de templates van marktplaatsen, de filters in je webshop, de vergelijkingstabellen, de gedrukte catalogus en de datapools. De vragen die kopers stellen voordat ze kopen, vertellen je welke attributen moeten bestaan en op welke je moet kunnen filteren.
Deel elk attribuut in bij een laag en geef het één eigenaar
Markeer elk attribuut als masterdata, rijke data of metadata, en benoem het systeem en het team dat er eigenaar van is. Masterdata waarvan het ERP eigenaar is, lees je in de PIM, maar bewerk je daar niet.
Teken de productmodellen en de variantassen
Bepaal wat een product in je catalogus is en welke attributen varianten maken, zoals kleur en maat. Bepaal voor elk attribuut het hoogste niveau waar het klopt. Beperk de variantniveaus tot de keuzes die een koper echt maakt.
Bouw de classificatie en de attribuutsets
Ontwerp de klassenboom die de attributen bepaalt, los van de navigatie. Voeg globale attributen, familie- en klasseattributen toe met typen, eenheden en lijsten, markeer wat per kanaal verplicht is, en map je klassen op de standaarden die je partners gebruiken.
Leg de relatietypen vast en test met echte producten
Benoem elk relatietype, de richting en de attributen die het draagt, en bepaal wie het onderhoudt. Laad daarna je lastigste producten, de bundels, de reserveonderdelen en de artikelen met tien varianten, en controleer of het model ze zonder workarounds aankan.
Veelgemaakte modelleerfouten
De meeste van deze fouten beginnen klein en groeien met elke import. Een variantstructuur of klassenboom later wijzigen betekent elk product eronder migreren. Daarom verdient het model aan het begin van een PIM-project echte ontwerptijd.
Wat dit betekent als je een PIM kiest
PIM's verschillen meer in hun datamodel dan hun functielijsten doen vermoeden. Twee systemen kunnen allebei "varianten" en "relaties" claimen en ze heel verschillend afhandelen. Test het model met je eigen producten voordat je iets anders vergelijkt.
- Varianten en overerving: hoeveel variantniveaus een familie kan hebben, of geërfde en lokale waarden duidelijk gemarkeerd zijn, en of je overrides in bulk kunt vinden en terugzetten.
- Hiërarchieën: of de PIM een hoofdclassificatie en aparte navigatiebomen naast elkaar bijhoudt, en of een product in veel navigatiebomen kan voorkomen.
- Classificatie en attribuutsets: of attributen langs de klassenboom erven, of eisen per kanaal kunnen verschillen, en of standaarden zoals GS1 GPC, ETIM of ECLASS kunnen worden geïmporteerd en gemapt.
- Relaties: getypeerde relaties met een richting, attributen op de relatie, en een andere kant die automatisch wordt bijgewerkt.
- Metadata: historie, herkomst, volledigheid per kanaal en assetrechten waarover je kunt rapporteren.
- Verandering: wat er gebeurt als je na de go-live een attribuut aan een familie toevoegt of een variantas wijzigt.
PIM-functies en -mogelijkheden zet deze punten naast de rest van de functies van een PIM, en wat is PIM legt uit hoe het model in het systeem als geheel past. Ben je klaar om leveranciers te vergelijken, dan laat hoe selecteer je de juiste PIM zien hoe je je model omzet in een gescripte demo.
Hoe je verder gaat
Frequently asked questions
Wat is een productdatamodel?
Een productdatamodel is de blauwdruk waarmee een PIM producten opslaat: welke soorten records er bestaan (producten, varianten, categorieën, merken, assets), welke attributen elk record heeft, hoe records in hiërarchieën worden gegroepeerd en met relaties worden verbonden, en welke waarden worden geërfd. Het bepaalt wat de PIM kan uitdrukken en hoeveel werk elk nieuw product kost.
Wat is het verschil tussen masterdata en rijke productdata?
Masterdata identificeert het product en verandert zelden: het artikelnummer, de GTIN, het merk, de eenheden, het gewicht en de afmetingen. Elk systeem heeft dezelfde waarden nodig, dus meestal worden ze in het ERP of een MDM aangemaakt. Rijke data legt het product uit en verkoopt het: namen, beschrijvingen, kenmerken, beelden en maattabellen. Die verandert vaak, wordt per markt vertaald en wordt in de PIM beheerd.
Wat is het verschil tussen een product, een variant en een SKU?
Het product is het model dat een klant herkent, zoals één schoenmodel. Een variant is één versie daarvan die een koper kan kiezen, bepaald door variantattributen zoals kleur en maat. De SKU is de eigen code van het bedrijf voor één exacte variant, waarmee het die variant telt, opslaat en verkoopt. Een variant heeft meestal één SKU, maar het woord betekent in elk systeem net iets anders.
Hoe werkt overerving van attributen in een PIM?
Je zet waarden op het hoogste niveau waar ze kloppen, en van daaruit worden ze naar beneden doorgegeven. Een merk of beschrijving op het productmodel wordt geërfd door elke variant, en een waarde op een kleur wordt geërfd door elke maat van die kleur. Wijzig de waarde één keer bovenaan en elk record eronder volgt. Heeft een record een andere waarde nodig, dan krijgt het een override. Die houdt de geërfde waarde tegen voor dat record en de records eronder.
Wanneer gebruik ik een productrelatie in plaats van een hiërarchie?
Gebruik een hiërarchie als een record precies één natuurlijke ouder heeft en daarvan moet erven, zoals bij categorieën, productmodellen en varianten. Gebruik een getypeerde relatie als records dwars door de hiërarchie heen gekoppeld zijn: accessoires, reserveonderdelen, compatibele producten, opvolgers, bundels en sets. Een relatie verbindt twee records, maar kopieert geen waarden van het ene naar het andere.
Wat is een attribuutset in een PIM?
Een attribuutset, vaak familie of template genoemd, is de lijst met attributen die een groep producten moet of mag hebben. Meestal bouwt die lijst zich op langs de classificatie: attributen die elk product heeft, meer uit de productfamilie en de meest specifieke uit de klasse. De set legt ook vast welke attributen verplicht zijn, vaak per kanaal.
Is een GTIN hetzelfde als een SKU?
Nee. Een SKU is de eigen interne code van een bedrijf, dus een leverancier en een retailer hebben elk een andere SKU voor hetzelfde artikel. Een GTIN is een wereldwijd uniek nummer dat binnen het GS1-systeem wordt uitgegeven en in de barcode staat, zodat elke handelspartner en elke scanner hetzelfde nummer ziet. Elk verpakkingsniveau, zoals een losse eenheid en een omdoos, krijgt een eigen GTIN.
Hoeveel variantniveaus moet een productmodel hebben?
Zoveel als de koper echte keuzes heeft, en meestal niet meer dan twee. Mode gebruikt vaak twee niveaus, eerst kleur en dan maat, omdat beelden bij de kleur horen en voorraad bij de maat. Een boormachine die met of zonder accu wordt verkocht, heeft er één nodig. Elk extra niveau voegt records toe die je moet onderhouden, dus voeg alleen een niveau toe als waarden op dat niveau echt verschillen.
Diagnose
Heb je eigenlijk wel een PIM nodig?
Draai eerst de complexiteitsindex voordat je software budgetteert of een systeemintegrator inhuurt.
Budget
Maak een eerste TCO-berekening
Zet de vorm van je catalogus in minder dan tien minuten om in een kostenrange voor drie jaar.