Field
En gruvkoncern samlade 500 000 produktposter
Nathalie · 2026-01-12 · Uppdaterad 2026-10-23 · 6 min läsning
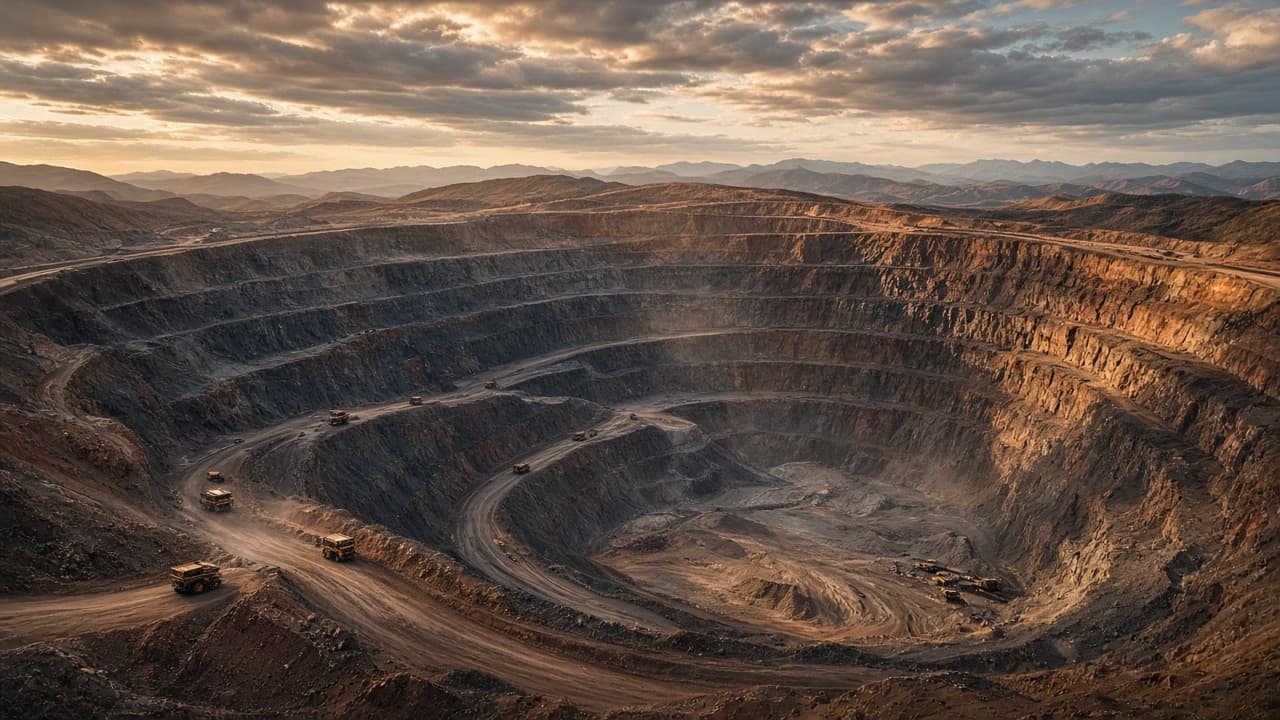
Gruvkoncernen fick en produktkatalog genom att köra datamodellen, plattformen och berikningen som ett enda jobb. Den är verksam i 12 regioner eller fler. Decennier av tillväxt och förvärv hade lämnat mer än 500 000 produktposter spridda över ERP-instanser, inköpsplattformar och lokala kalkylblad, på olika språk och med olika logik för klassificering. PIMvendors tog fram en UNSPSC-modell, drev valet av plattform för produktinformationshantering (PIM) och masterdatahantering (MDM) och satte industriell AI på städningen, med en person som granskar utfallet.
Läget
Samma hydraulpump kunde dyka upp som fem beskrivningar, på tre språk, under två UNSPSC-koder, utan något som kopplade ihop dem. För en koncern som lägger miljarder om året på MRO-material är den splittringen ett kostnadsproblem, ett säkerhetsproblem och ett problem med stillestånd.
Underhållsteamen hittade inte rätt delar. Inköp såg inte när samma vara köptes dubbelt. Strategiskt inköp kunde inte samla leverantörerna. De regionala teamen hade lärt sig att gå runt katalogen. Tidigare städningar med generell AI och massomklassificering hade misslyckats. Krossfoder, segment till transportband och specialiserade filtermedia finns inte i databaser för konsumentprodukter, så generell berikning gav ett utfall som teamen inte kunde använda.
Koncernen bad PIMvendors leverera tre arbetsspår: en gemensam modell för produktdata, en plattform för PIM och MDM, och städning och berikning med AI byggd för industriell MRO.
Arbetsspår 1: produktdatamodell
Inga två regioner beskrev en produkt på samma sätt. Vissa anläggningar höll tekniska specifikationer. Andra förlitade sig på fritext som lagerpersonal skrev in. Det fanns ingen gemensam taxonomi, ingen överenskommen uppsättning attribut och ingen definition av en komplett post.
PIMvendors förankrade modellen i UNSPSC, den klassificering som används mest för indirekt material och MRO. De regionala strukturerna ställdes mot den modellen för att hitta luckor, konflikter och dubbletter. Varje kategori fick obligatoriska och valfria attribut, standardenheter och namnregler som fungerar på mer än ett språk.
Det prövades med inköpsansvariga, underhållsingenjörer och lagerchefer i fyra pilotregioner. Provet var operativt. Om en tekniker inte hittade en bärulle till ett transportband inom tre klick från den nya klassificeringen och attributen gick modellen tillbaka för omarbetning.
Utfallet är en UNSPSC-modell som täcker 100 % av koncernens MRO-kategorier. Varje kategori har en attributmall och regler för validering, så kvaliteten kontrolleras när en post skapas.
Arbetsspår 2: val av plattform
Det fanns inget centralt system för posten. Modulerna för masterdata i ERP hanterade transaktioner och erbjöd inget arbetsflöde, ingen datastyrning (data governance) och ingen berikning. Dataförvaltarna höll sina egna golden records i Excel. En central plattform måste klara styrning över flera regioner, flera språk och volymen i en industriell MRO-katalog.
PIMvendors drev ett val från en lång lista med mer än 15 plattformar för PIM och MDM ner till en kortlista (shortlist) på 3. Kriterierna var konkreta: UNSPSC-hierarkier i den här skalan, onboarding från ERP-system som inte matchar varandra, en passning mot de AI-verktyg som planerades för det tredje arbetsspåret, samt koncernens IT-arkitektur och säkerhetsregler.
Varje systemleverantör på kortlistan visade en demo på kundens egen data, från ett manus. Generella demomängder hölls utanför rummet. Panelerna omfattade IT, inköp, underhåll och datastyrning. PIMvendors lämnade en oberoende poäng och en rekommendation, med total ägandekostnad (TCO) över fem år.
Plattformen valdes och färdplanen för införandet levererades inom 10 veckor. Den är specificerad för mer än 500 000 SKU, 12 regionala flöden eller fler och 8 språk, med arbetsflöde för förvaltning, rutter för godkännande och onboarding av leverantörer.
Arbetsspår 3: städning och berikning
Historiken var fortfarande en röra efter att modellen och plattformen hade valts. Över 40 % av posterna var fritext utan strukturerade attribut. Träffsäkerheten i klassificeringen över katalogen uppskattades till under 60 %. Dubbletter fanns överallt. Generella språkmodeller, tränade på konsumentprodukter, kunde inte skilja en vridspjällsventil av typ 3 från en av typ 5, eller ett foder till en kulkvarn från generellt metallarbete.
PIMvendors identifierade, utvärderade och driftsatte AI-verktyg byggda för industriell berikning och MRO. De verktygen är tränade på miljontals industriella produktposter och tekniska datablad, vilket är det ordförråd som generella modeller saknar.
Flödet hade tre steg. Klassificeringen tilldelade en UNSPSC-kod utifrån beskrivningen, de attribut som redan fanns och sammanhanget runt posten. Uttaget av attribut drog material, mått, driftspecifikationer och OEM-artikelnummer ur fritexten och in i modellen. Upptäckten av dubbletter använde probabilistisk matchning över regioner och flaggade kluster för sammanslagning.
En förvaltare granskade varje förslag från AI, i batcher: godkänn, rätta eller avvisa. Den slingan förbättrade modellen och lämnade koncernen med kontroll över sin masterdata.
Andelen fritextposter föll från över 40 % till under 10 %. Träffsäkerheten i klassificeringen steg till över 95 %. Kluster av dubbletter slogs ihop, och den aktiva katalogen krympte med uppskattningsvis 15 till 20 %. Onboarding av en ny produkt, tidigare veckor av manuell inmatning och korskontroller, tar nu dagar.
Den samlade effekten
Modellen ger strukturen. Plattformen ger styrningen. AI ger takten på hundratusentals poster. Alla 12 regioner eller fler arbetar nu från en katalog. Inköp kan analysera vad som köps, samla leverantörer och förhandla på volym, vilket den gamla splittringen gjorde omöjligt. Underhåll hittar delar snabbare, vilket kortar stilleståndet på utrustningen. En ny produkt, en ny leverantör eller en ny region matar samma modell, samma plattform och samma flöde.
På MRO-inköp i den här storleken är en vinst på 1 till 2 % i inköpet tiotals miljoner om året. En katalog man kan lita på är villkoret för den vinsten.
Det som måste röra sig samtidigt
Rättar du modellen och hoppar över verktygen får du en taxonomi som ingen fyller i. Sätter du in AI utan modellen blir utfallet snabbt och fel. Väljer du en plattform utan datan och flödet för berikning betalar du för ett system som inte passar. De tre rörde sig tillsammans, med oberoende råd över modellen, valet och AI, och det är det som gav skiften ovan.
Avvägningen är den mänskliga kontrollen. En förvaltare på varje förslag är långsammare än att låta modellen skriva katalogen utan tillsyn. Det är också därför en köpare kan använda en siffra för klassificering över 95 %. En annan industriell köpare kan kopiera ordningen: UNSPSC och attributmallarna, sedan plattformen, sedan domän-AI med en person på utfallet.
Vad MDM är är problemet med systemet för posten som regionerna löste med Excel. Så väljer du ett PIM är vägen från 15 plattformar till 3, körd på kundens egen data. AI-redo produktdata är det posten behöver innan en modell klassificerar den, vilket är därför generella modeller för konsumentvaror föll på en vridspjällsventil. Datakvalitet och datastyrning är förvaltarsteget som sitter ovanpå AI, och definitionen av en komplett MRO-post som koncernen inte hade.
Diagnos
Behöver du faktiskt ett PIM?
Kör komplexitetsindexet innan du budgeterar programvara eller tar in en systemintegratör.
Mötet hålls på engelska.
Budget
Gör en första TCO
Översätt katalogens form till ett kostnadsintervall över tre år, på under tio minuter.
Mötet hålls på engelska.